Inference Engineering: bản đồ toàn cảnh
Giới thiệu
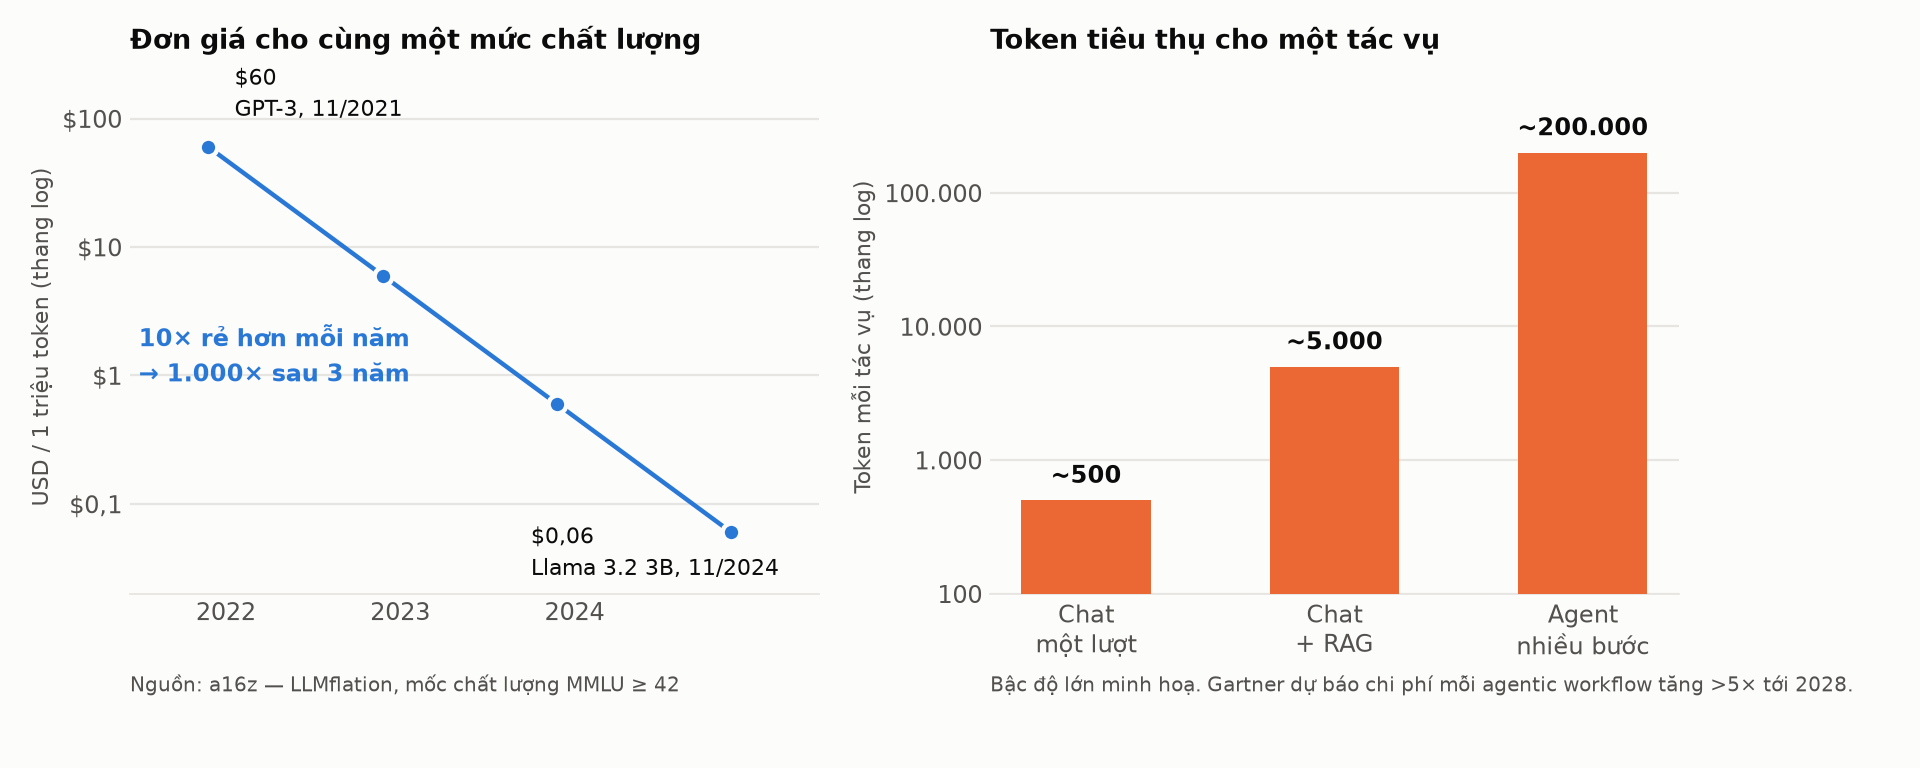
Cuối năm 2021, để chạy một model đạt mức MMLU ≥ 42, mọi người phải trả khoảng 60 đô cho mỗi triệu token. Ba năm sau, cũng mức chất lượng đó, con số là 6 cent. Rẻ đi một nghìn lần.
Vậy mà hoá đơn AI của gần như mọi đội mình biết đều đang đi lên.
Nghe vô lý, nhưng lý do lại rất đơn giản: mỗi thế hệ ứng dụng mới lại ăn nhiều token hơn đúng phần vừa tiết kiệm được. Một câu chat đơn giản tốn vài trăm token. Thêm RAG vào thì thành vài nghìn. Chuyển sang một agent biết suy luận, tự gọi tool, tự sửa sai qua vài chục vòng lặp — con số nhảy lên hàng trăm nghìn. Gartner dự báo chi phí inference mỗi agentic workflow sẽ tăng hơn 5 lần từ nay tới 2028, kể cả khi đơn giá mỗi token vẫn tiếp tục giảm.
Khoảng chênh giữa hai đường cong đó — đơn giá đi xuống, lượng tiêu thụ đi lên còn nhanh hơn — chính là chỗ mà inference engineering sinh ra như một nghề riêng.
Đây là bài mở đầu cho một chuỗi dài mình dự định viết trong khoảng tám tháng tới: 67 bài về inference engineering, từ kiến trúc GPU, cơ chế hoạt động của LLM khi suy luận, mổ xẻ source code vLLM và SGLang, viết kernel Triton, nén mô hình, cho tới serving ở quy mô cụm. Bài này không dạy kỹ thuật cụ thể nào cả. Nó là tấm bản đồ: nghề này là gì, nó lớn cỡ nào, stack của nó gồm những tầng nào, và mọi người nên đọc chuỗi này theo thứ tự nào cho hợp với mình.
Inference engineering là gì
Cách phân biệt gọn nhất mình tìm được là nhìn vào thứ được giao ra cuối cùng.
Training là một dự án có điểm kết thúc. Mọi người chạy nó vài tuần, tốn một đống tiền, và nhận về một thứ duy nhất: một file checkpoint. Thước đo là loss, là điểm trên benchmark. Xong thì thôi.
Inference thì không bao giờ xong. Nó chạy 24/7, mỗi request là một lần tiêu tiền, và thứ giao ra không phải một file mà là một dòng token chảy liên tục tới người dùng. Thước đo cũng khác hẳn: TTFT (thời gian tới token đầu tiên), TPOT (thời gian giữa hai token), throughput, và cuối cùng là đô la trên mỗi triệu token.
Nói ngắn gọn, inference engineering là việc biến một checkpoint thành một dịch vụ chạy được ở mức latency và chi phí chấp nhận được.
Mọi người có thể thấy nó khác gì với các vai trò lân cận:
| Vai trò | Câu hỏi trung tâm |
|---|---|
| Researcher | Kiến trúc nào, dữ liệu nào cho model tốt hơn? |
| ML engineer | Làm sao train / fine-tune được model này? |
| MLOps, Platform engineer | Làm sao deploy, giám sát, rollback được nó? |
| Inference engineer | Làm sao chạy nó nhanh hơn và rẻ hơn, trên đúng phần cứng đang có? |
Ranh giới với MLOps là chỗ hay bị lẫn nhất. MLOps lo phần xung quanh model — pipeline, container, monitoring, autoscaling. Inference engineering lo phần bên trong: KV cache đang chiếm bao nhiêu VRAM, scheduler đang preempt request nào, kernel attention đang chạy backend gì, batch size bao nhiêu thì GPU bão hoà. Nó là tầng nằm kẹp giữa model và phần cứng, và để làm được thì phải hiểu cả hai đầu.
Có hai luận điểm mình sẽ nhắc lại rất nhiều lần trong chuỗi này, nên nói luôn từ đầu:
Latency là sản phẩm. Cùng một model, một con chatbot trả lời sau 200ms và một con trả lời sau 2 giây là hai sản phẩm khác nhau, không phải một sản phẩm "hơi chậm hơn". Với agent chạy ba mươi bước liên tiếp, chênh lệch TPOT giữa 20ms và 50ms là chênh lệch giữa "dùng được" và "không ai đủ kiên nhẫn ngồi đợi".
Chi phí token là biên lợi nhuận. Nếu mọi người bán gói 20 đô một tháng mà chi phí inference cho mỗi người dùng là 18 đô, thì không có mô hình kinh doanh nào ở đây cả. Mọi kỹ thuật trong 67 bài sắp tới — quantization, prefix caching, continuous batching, speculative decoding — cuối cùng đều quy về việc kéo con số 18 đó xuống.
Nghề này lớn cỡ nào
Phần này mình bổ sung thêm so với dự định ban đầu, vì khi ngồi gom số liệu để tự thuyết phục mình rằng chuỗi bài này đáng viết, mình thấy mấy con số này tự nó đã là một câu chuyện.
Tiền đã dịch chuyển từ training sang inference
Tháng 8/2026, Gartner công bố một dự báo mà mình nghĩ là cột mốc đáng nhớ: 2026 là năm đầu tiên chi tiêu toàn cầu cho inference (23,3 tỷ đô) vượt qua chi tiêu cho training (19 tỷ đô). Cùng báo cáo đó, thị trường AI-optimized IaaS được dự báo đạt 42 tỷ đô trong năm 2026, tăng 96% so với 21,5 tỷ đô của năm 2025 — và 55% số tiền ấy chảy vào inference, con số này lên 59% vào năm 2027.
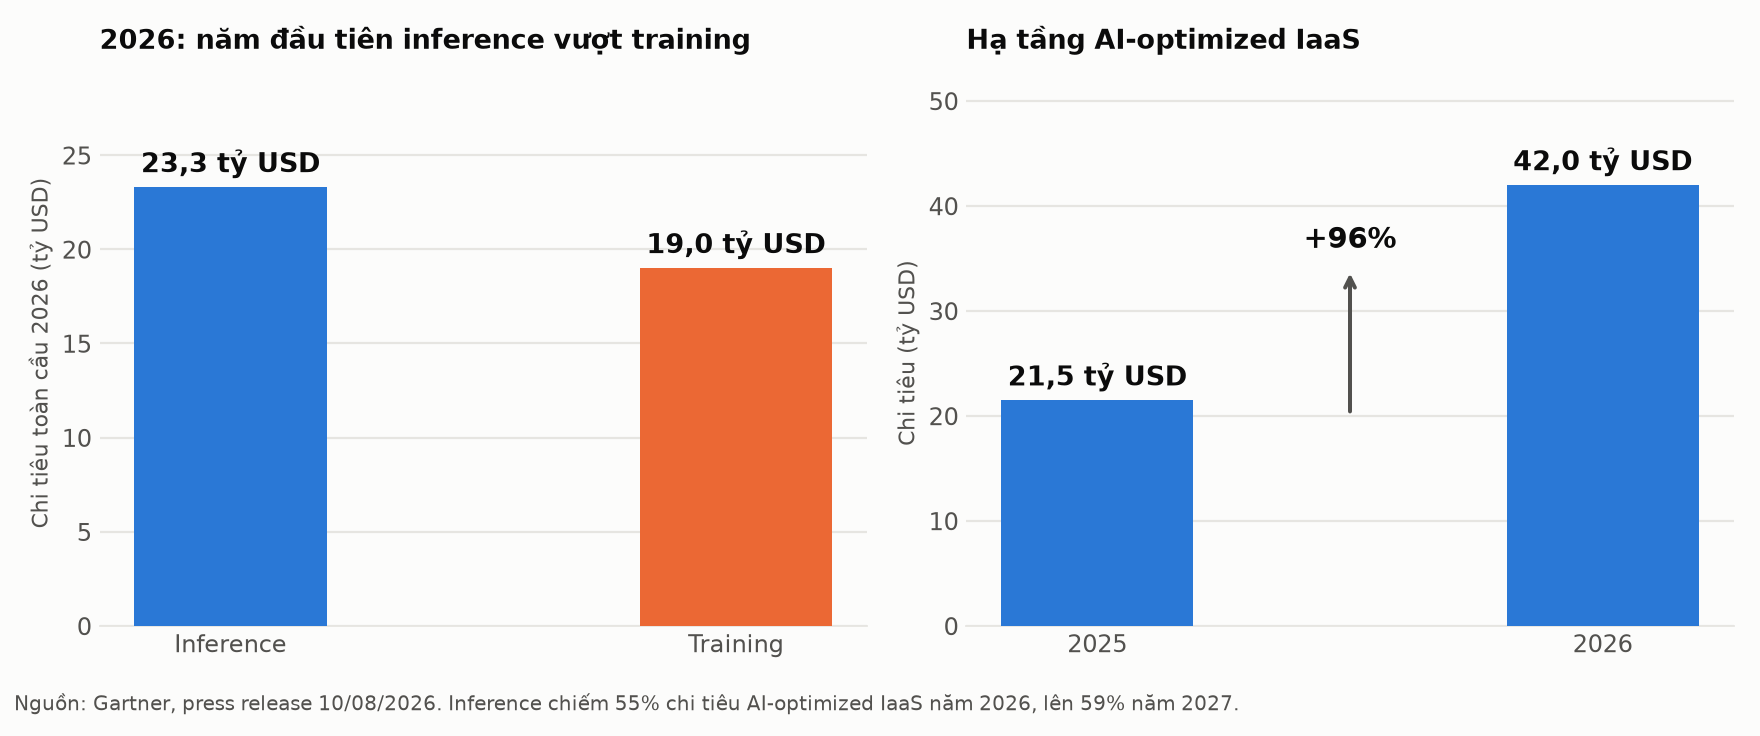
Trong khoảng 2020–2024, chỗ hấp dẫn nhất của ngành là train ra được model tốt. Giờ thì model tốt đã có sẵn, phần lớn là open-weight, tải về là chạy. Bài toán đã dịch sang: chạy nó thế nào cho không lỗ.
Nghịch lý: token rẻ đi nhưng hoá đơn đắt lên
a16z gọi hiện tượng giá token sụp đổ là LLMflation, và đo được tốc độ giảm 10 lần mỗi năm cho cùng một mức chất lượng — nhanh hơn cả Moore's Law thời PC hay tốc độ băng thông thời dotcom. Gartner còn dự báo tới năm 2030, chạy inference trên một LLM nghìn tỷ tham số sẽ rẻ hơn 90% so với 2025.
Nhưng ở chiều ngược lại, cũng chính Gartner dự báo chi phí inference mỗi agentic workflow tăng hơn 5 lần tới 2028. Will Sommer, Sr. Director Analyst của Gartner, nói một câu mình thấy rất đúng:
"Product leaders cannot rely on more efficient token economics to rationalize AI costs. Each successive generation of AI capability will necessitate more, and often more expensive, tokens."
Con số minh hoạ rõ nhất cho vế "nhiều token hơn" đến từ Epoch AI: lượng token Google xử lý tăng 330 lần chỉ trong hai năm, từ 5/2024 đến 5/2026.
Đây chính là lý do nghề này không biến mất khi phần cứng rẻ đi. Phần cứng rẻ đi bao nhiêu thì ứng dụng lại phình ra bấy nhiêu.
Thị trường lao động
Báo cáo AI Index 2026 của Stanford HAI ghi nhận AI được nhắc tới trong 2,5% tổng số tin tuyển dụng ở Mỹ, tăng 55% so với năm trước. Riêng cụm từ "agentic AI" trong tin tuyển dụng tăng hơn 280% chỉ trong một năm.
Về mức lương, mình gom từ vài nguồn tuyển dụng và xin nói trước là các con số này đến từ các công ty tuyển dụng thương mại (ZipRecruiter, KORE1, Recruiting from Scratch), không phải khảo sát học thuật, nên mọi người đọc ở mức tham khảo:
- Vị trí liên quan ML inference nói chung: khoảng 98.000 – 173.000 USD/năm.
- Median lương quảng cáo cho vị trí LLM Engineer: 179.000 – 230.000 USD/năm.
- Vị trí chuyên sâu về fine-tuning và inference: tổng thu nhập 220.000 – 350.000 USD.
- Senior: 195.000 – 265.000 USD lương cơ bản, vượt 300.000 nếu tính cả equity.
Điểm mình thấy đáng chú ý hơn cả con số là tổ hợp kỹ năng đang được trả giá cao nhất: Kubernetes + Terraform + một engine serving cụ thể (vLLM, TensorRT-LLM hoặc Triton). Tức là thị trường không tìm người biết dùng API, mà tìm người biết vận hành hạ tầng inference.
Và đây là nhận định của riêng mình, không phải của hãng phân tích nào: cái làm nghề này khác các nhánh software khác là giá trị của nó đo được trực tiếp bằng tiền. Rất ít vị trí kỹ thuật mà mọi người có thể nói thẳng với sếp rằng "tháng trước hoá đơn GPU là X, tháng này là X/2, và đây là biểu đồ benchmark chứng minh chất lượng output không đổi". Mình nghĩ đó mới là lý do thật sự đằng sau những con số lương ở trên, chứ không phải vì AI đang hot.
Stack năm tầng
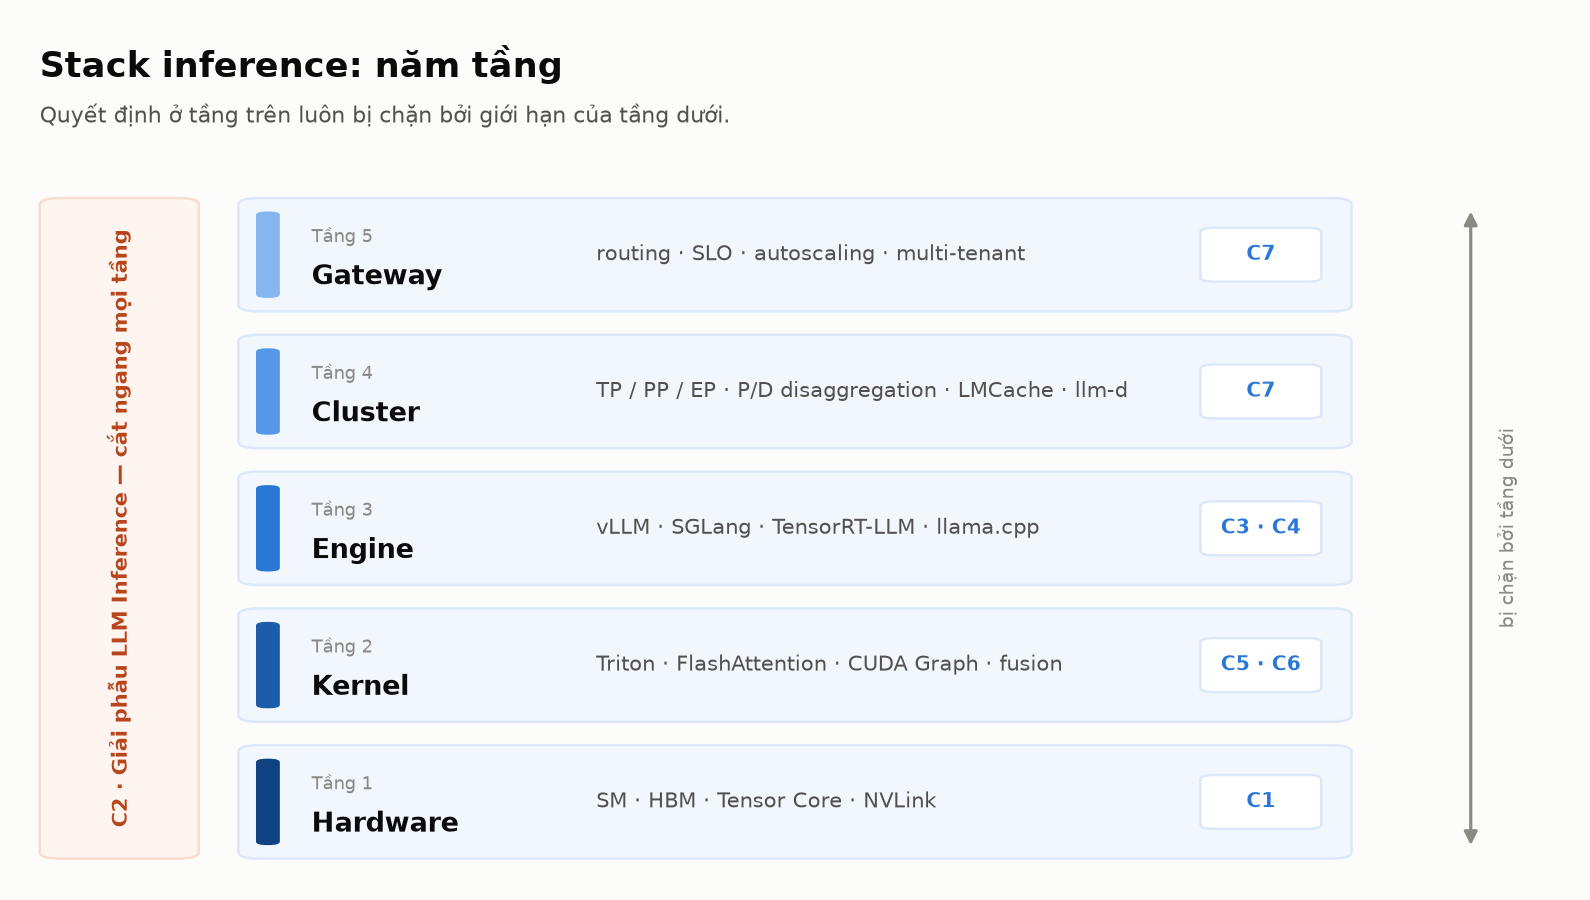
Quay lại sơ đồ ở đầu bài. Mình chia toàn bộ thứ gọi là "hệ thống inference" thành năm tầng, và cả 67 bài sau này đều nằm gọn ở một trong năm tầng đó.
Tầng 1 — Hardware. SM, warp, phân cấp bộ nhớ register → SMEM → L2 → HBM, tensor core và các định dạng số, NVLink. Đây là tầng mọi người không chỉnh được gì cả, nhưng bắt buộc phải biết giới hạn của nó. Gần như mọi con số hiệu năng ở bốn tầng trên đều là hệ quả của hai thông số ở tầng này: dung lượng HBM và băng thông HBM.
Tầng 2 — Kernel. Các hàm chạy trên GPU: attention, GEMM, RMSNorm, RoPE, sampling. Đây là tầng của Triton, FlashAttention, CUDA Graph, và nghệ thuật fusion. Nguyên tắc duy nhất ở tầng này: tối ưu nghĩa là giảm số byte đi qua HBM.
Tầng 3 — Engine. vLLM, SGLang, TensorRT-LLM, llama.cpp. Tầng này quản lý KV cache, lập lịch request, gom batch, chọn kernel nào cho shape nào. Đây là tầng mà đa số mọi người sẽ dành nhiều thời gian nhất, vì nó là chỗ một dòng cấu hình có thể đổi throughput gấp đôi.
Tầng 4 — Cluster. Khi một GPU không đủ. Tensor/pipeline/expert parallel, tách prefill khỏi decode ra hai cụm riêng, KV cache phân tầng từ HBM xuống DRAM xuống NVMe. Tầng này sinh ra một loại chi phí mới mà ba tầng dưới không có: chi phí giao tiếp qua mạng.
Tầng 5 — Gateway. Định tuyến request giữa nhiều pod, autoscaling theo tín hiệu inference thật thay vì theo CPU, đảm bảo SLO, phục vụ nhiều tenant. Tầng này gần với SRE hơn là với GPU, nhưng quyết định ở đây (ví dụ round-robin hay prefix-aware routing) lại đập ngược xuống tận tầng 3.
Điểm quan trọng nhất của sơ đồ này nằm ở mũi tên bên phải: quyết định ở tầng trên luôn bị chặn bởi giới hạn của tầng dưới. Mọi người không thể tune vLLM để thoát khỏi việc decode là memory-bound, vì đó là tính chất của phép nhân ma trận–vector ở tầng 1. Không thể cấu hình gateway để bù cho việc KV cache tràn VRAM. Đây là lý do chuỗi này bắt đầu từ dưới lên, chứ không bắt đầu bằng "cách deploy một LLM".
Có một mảng không nằm gọn vào tầng nào: cơ chế inference của chính LLM — prefill, decode, KV cache, batching, sampling. Nó cắt dọc qua cả năm tầng, nên mình tách riêng thành một chuỗi (C2) và đó cũng là chuỗi nền tảng nhất.
Ba câu hỏi trung tâm
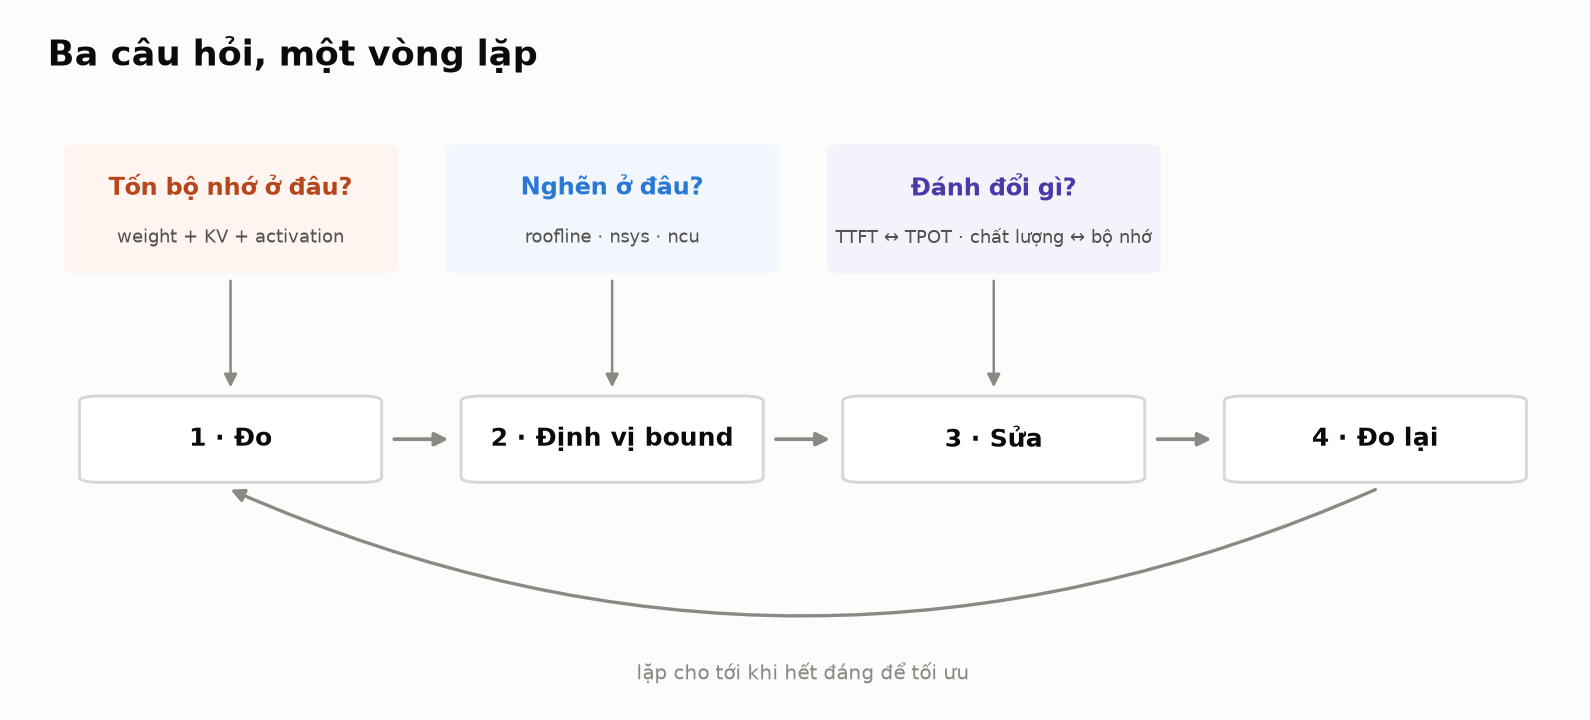
Dù đang đứng ở tầng nào, mình thấy công việc rốt cuộc luôn quy về ba câu hỏi:
- Nghẽn ở đâu?
- Tốn bộ nhớ ở đâu?
- Đánh đổi gì?
Nếu chỉ nói suông thì ba câu này là khẩu hiệu. Nên mình sẽ trả lời cả ba ngay tại đây, bằng một ví dụ tính tay: chạy Llama-3.1-8B ở BF16 trên một RTX 4090 24GB — đúng cấu hình lab của toàn bộ chuỗi này.
Nghẽn ở đâu
Công cụ trả lời câu này là roofline model. Ý tưởng của nó là so sánh arithmetic intensity của phép tính (số FLOP thực hiện trên mỗi byte đọc từ bộ nhớ) với ridge point của GPU — tỉ số giữa năng lực tính toán và băng thông bộ nhớ.
Với 4090: khoảng 165,2 TFLOPS ở BF16 (tensor core, dense) và 1.008 GB/s băng thông.
Giờ nhìn vào bước decode. Mỗi bước decode chỉ sinh một token, nên phép tính chủ đạo là nhân ma trận trọng số với một vector — GEMV. Với GEMV, mỗi phần tử trọng số được đọc lên một lần và chỉ dùng cho đúng một phép nhân–cộng, nên arithmetic intensity xấp xỉ 1 FLOP/byte, bất kể model to hay nhỏ.
Tức là decode nằm thấp hơn ridge point khoảng 160 lần. Đây không phải chuyện "code chưa tối ưu". Đây là decode bị đóng đinh sâu trong vùng memory-bound, và gần như mọi kỹ thuật tăng tốc decode sau này đều xuất phát từ sự thật đó.
Tốn bộ nhớ ở đâu
Ba khoản chính: trọng số model, KV cache, và activation cùng CUDA context. Tính thử:
Trọng số: tham số 2 byte 16,1 GB.
KV cache mỗi token, với = số layer, = số KV head, = chiều mỗi head:
Thay số của Llama-3.1-8B (, do dùng GQA, , BF16):
Trên card 24GB, sau khi trừ 16,1 GB trọng số và khoảng 1–2 GB cho CUDA context với activation, còn lại chừng 5–6 GB cho KV cache. Chia cho 128 KiB được khoảng 40.000 token tổng cộng — cho tất cả request đang chạy đồng thời.
Con số đó nghĩa là mọi người phải chọn: hoặc phục vụ 8 request với context 5K, hoặc một request duy nhất với context 40K. Không thể có cả hai. Và đây mới là model 8B, chưa phải model lớn.
Đánh đổi gì
Quantize trọng số xuống INT4 sẽ kéo 16,1 GB xuống còn khoảng 4,5 GB, giải phóng chỗ cho KV cache lên tầm 140.000 token — gấp hơn ba lần. Đổi lại, chất lượng output giảm, và mức giảm phụ thuộc vào recipe lẫn loại tác vụ.
Bật chunked prefill sẽ làm TPOT ổn định hơn hẳn vì prompt dài không còn chặn ngang các request đang decode. Đổi lại, TTFT của chính prompt dài đó xấu đi.
Bật prefix caching giúp TTFT giảm mạnh với workload có system prompt dài. Đổi lại, tốn thêm VRAM cho cache và thêm một cơ chế phải giám sát.
Mọi người sẽ thấy quy luật: không có nút nào chỉ toàn lợi. Mỗi tối ưu đều lấy từ chỗ này bù sang chỗ kia. Công việc của inference engineer là biết workload của mình nhạy với cái gì để đổi cho đúng chiều. Đây là luận điểm xuyên suốt cả 67 bài.
Các con số ở trên mình tính tay từ thông số công bố. Trong các bài sau, mọi con số hiệu năng sẽ được đo lại trên máy thật và ghi rõ phiên bản engine, checkpoint model, độ dài input/output cùng mức concurrency — vì số liệu không kèm ngữ cảnh thì vô nghĩa.
Tám chuỗi con
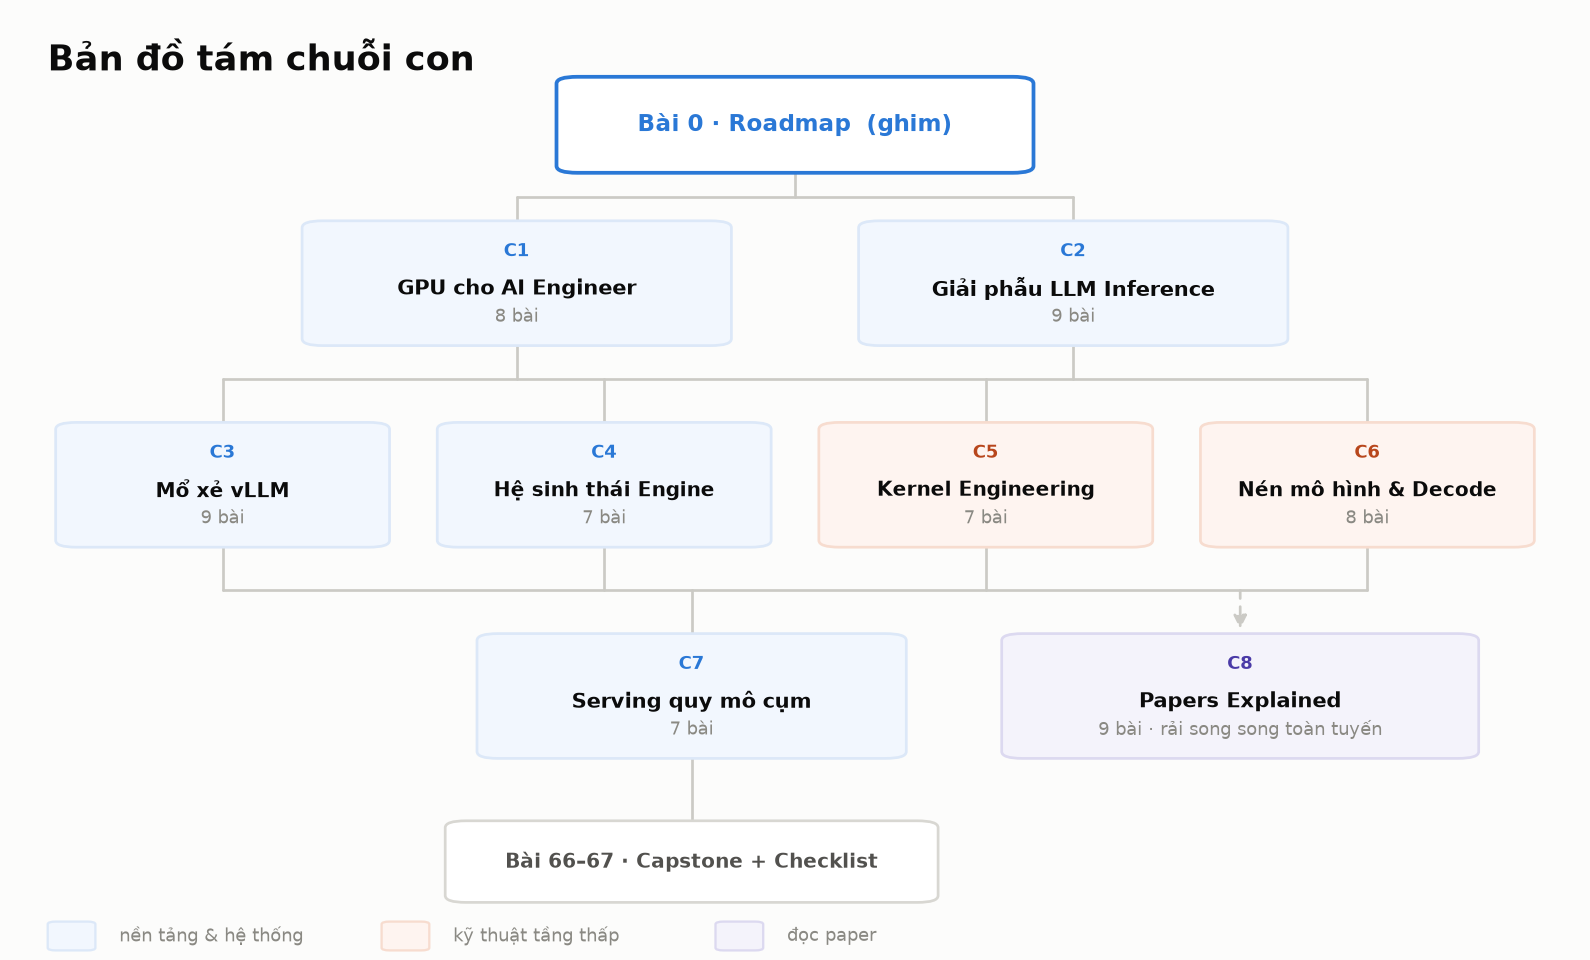
| Chuỗi | Số bài | Trả lời câu hỏi |
|---|---|---|
| GPU cho AI Engineer | 8 | Nhìn một model và một GPU, đoán được nó nghẽn ở đâu? |
| Giải phẫu LLM Inference | 9 | LLM thực sự làm gì khi suy luận, độc lập với mọi engine? |
| Mổ xẻ vLLM | 9 | Đọc được source vLLM V1 và tune nó có cơ sở? |
| Hệ sinh thái Inference Engine | 7 | Chọn engine nào cho workload nào? |
| Kernel Engineering | 7 | Tự viết được kernel và đọc hiểu kernel của engine? |
| Nén mô hình & Tăng tốc Decode | 8 | Làm model nhỏ hơn và decode nhanh hơn mà không hỏng chất lượng? |
| Serving quy mô cụm | 7 | Khi một GPU không đủ thì kiến trúc thay đổi thế nào? |
| Papers Explained: Inference | 9 | Những paper nào đã định hình ngành này, và họ lập luận ra sao? |
Cộng thêm bài mở đầu này, một bài capstone dựng trọn stack trên một GPU 24GB, và một bài checklist tra cứu theo triệu chứng — tổng cộng 67 bài, nhịp 2 bài mỗi tuần.
Lúc mọi người đọc bài này thì phần lớn trong số đó chưa tồn tại, nên mình chưa gắn link được. Toàn bộ chuỗi sẽ dồn về trang category Inference Engineering — mọi người có thể bookmark trang đó, hoặc quay lại chính bài này vì mình sẽ cập nhật link dần sau mỗi giai đoạn.
Đọc theo lộ trình nào
Chuỗi này được thiết kế để không phải ai cũng đọc từ đầu tới cuối. Tuỳ mọi người đang đứng ở đâu:
| Nếu mọi người là... | Nên bắt đầu từ | Có thể bỏ qua |
|---|---|---|
| Backend / Platform engineer mới chạm LLM | Giải phẫu LLM Inference → Mổ xẻ vLLM → bài tune vLLM → bài checklist | Toàn bộ chuỗi Kernel Engineering |
| ML engineer đã train model nhưng chưa serve bao giờ | Bài Prefill và Decode → KV cache → Ngân sách bộ nhớ GPU → Mổ xẻ vLLM | Ba bài đầu của chuỗi GPU |
| Muốn đi sâu kernel và CUDA | GPU cho AI Engineer → Kernel Engineering → Nén mô hình | Chuỗi Serving quy mô cụm |
| Đọc để ra quyết định (tech lead, founder) | Bài này → Mô hình chi phí → Chọn engine nào → bài checklist | Mọi bài có lab thực nghiệm |
Nếu mọi người chưa biết mình thuộc nhóm nào, cứ đọc theo thứ tự. Chuỗi được xếp từ dưới lên đúng như stack năm tầng ở trên.
Chuỗi này không hứa gì
Mình muốn nói rõ giới hạn ngay từ bài đầu, để mọi người khỏi mất thời gian nếu nó không phải thứ mình cần.
Lab giới hạn ở một GPU consumer 24–32GB. Mọi thứ đánh dấu là chạy được thì mình đã chạy thật trên card đó. Nhưng phần multi-node, phần Blackwell, phần kiến trúc serving quy mô lớn thì mình không có phần cứng để dựng lại — những bài đó sẽ là đọc source code và phân tích số liệu công bố, và mình sẽ ghi rõ ngay đầu bài. Mình sẽ không giả vờ đã đo những thứ chưa đo.
Đây không phải tutorial "deploy LLM trong 5 phút". Kiểu bài đó đã nhiều rồi và cũng không giúp được gì khi hệ thống bắt đầu OOM lúc 2 giờ sáng. Chuỗi này đi theo hướng ngược lại: hiểu cơ chế trước, cấu hình sau.
Một phần nội dung sẽ cũ đi. vLLM và SGLang thay đổi từng tháng. Mọi đoạn code đọc source sẽ được pin theo version tag cụ thể, nhưng mọi người vẫn nên kiểm lại với bản mới nhất khi áp dụng. Phần cơ chế — roofline, KV cache, đánh đổi giữa TTFT và TPOT — thì bền hơn nhiều, và đó là phần mình đầu tư nhất.
Kết luận
Ba năm qua, phần thú vị nhất của ngành là train ra được model tốt. Giờ model tốt đã thành hàng hoá: tải về là chạy, phần lớn là open-weight. Chỗ khó còn lại, và cũng là chỗ tiền đang đổ về, là chạy chúng cho ra tiền.
Mọi người không cần nhớ gì nhiều từ bài này ngoài ba câu hỏi: nghẽn ở đâu, tốn bộ nhớ ở đâu, đánh đổi gì. 66 bài còn lại chỉ là trả lời ba câu đó ở từng tầng, với từng kỹ thuật, trên từng loại phần cứng.
Bài tiếp theo mình sẽ bắt đầu từ tầng thấp nhất: GPU khác CPU ở chỗ nào, và vì sao kiến trúc đó vốn sinh ra cho throughput lại luôn khó chịu với bài toán decode của LLM. Hẹn mọi người ở đó.
Tham khảo
Thị trường và kinh tế
- Gartner Forecasts Worldwide AI-Optimized IaaS Spending to Grow 96% in 2026 — 10/08/2026
- Gartner Predicts AI Inference Costs Per Agentic Workflow Will Increase More Than Fivefold Through 2028 — 17/08/2026
- Gartner Predicts That by 2030, Performing Inference on an LLM With 1 Trillion Parameters Will Cost GenAI Providers Over 90% Less Than in 2025 — 25/03/2026
- Welcome to LLMflation — LLM inference cost is going down fast — Andreessen Horowitz
- The 2026 AI Index Report — Stanford HAI
- Data on the Trajectory of AI — Epoch AI
Kỹ thuật nền